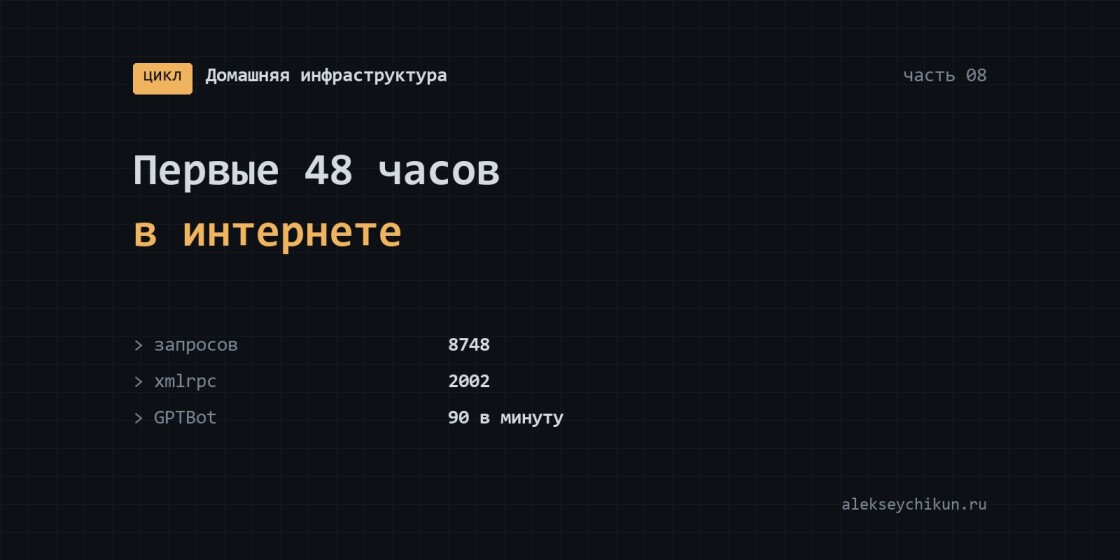
Порты 80 и 443 открылись наружу — и почти сразу в журнале пошли запросы, которых не делал ни один человек. Я выгрузил журнал обращений за первые двое суток — 8748 запросов — и посчитал, кто и зачем стучится в свежий домашний сервер. Картина поучительная, а среди «полезных» роботов нашёлся поисковик, который чуть не проиндексировал тестовую копию рабочего сайта.
Это восьмая часть цикла «Домашняя инфраструктура».
Кто пришёл за первые двое суток
| Что | Сколько | Зачем |
|---|---|---|
POST /xmlrpc.php с одного адреса | 2002 | подбор паролей WordPress — по сотне вариантов в одном запросе |
POST /wp-login.php с распределённых облачных адресов | 179 за 19 часов | медленный подбор, чтобы не попасть под лимиты |
зонды .env, .git, phpmyadmin, vendor/phpunit | 542 | поиск забытых конфигов, репозиториев и известных дыр |
batch/v1 и wp/v2/users REST API WordPress | 40 | перебор пользователей и попытки свежей уязвимости ядра |
| уникальных сканеров | 169 | — |
На SSH атак не было — порт наружу не открывали. Всё внимание досталось веб-серверу. И это всего двое суток жизни нового адреса, о котором никто не знал.
Три уровня защиты
1. В nginx каждого сайта
То, что не нужно ни одному сайту, закрываем в шаблоне nginx:
location = /xmlrpc.php { access_log off; log_not_found off; return 403; }Не используйте return 444, если nginx стоит за обратным прокси. 444 — «закрыть соединение без ответа», и прокси вернёт клиенту 502, как будто сайт сломан. За прокси — только 403 или 404.
2. В прокси — сразу для всех сайтов
Блокировки, общие для всех, удобнее держать на уровне traefik: одно правило в файловом провайдере — и оно действует на все сайты, включая будущие. Роутер без имени хоста с очень высоким приоритетом перехватывает подозрительные пути раньше роутеров сайтов:
http:
  routers:
    block-scanners:
      rule: "PathRegexp(`^/(\\.env|\\.git|phpmyadmin|vendor/phpunit)`)"
      priority: 98000
      middlewares: [deny-all]
      service: noop
  middlewares:
    deny-all:
      ipAllowList: { sourceRange: ["255.255.255.255/32"] }   # штатного «запретить» нет — разрешаем несуществующий адрес
  services:
    noop:
      loadBalancer: { servers: [{ url: "http://127.0.0.1:1" }] }
Отдельные роутеры с приоритетами 100 000 и 99 000 закрывают batch/v1 и перебор пользователей через REST.
У этой защиты есть честная дыра. Блокировка REST-путей стоит только для запросов без куки входа WordPress, иначе ломается редактор. Куку подделать — одна строка в запросе. Массовый сканер так не делает, поэтому от фона это защищает, а от целевой атаки — нет. Наглухо такие пути закрываются только в самом WordPress, mu-плагином.
3. fail2ban по журналу прокси
Почему не ограничение частоты запросов в прокси: подбор паролей шёл медленно — 179 попыток за 19 часов, это ниже любого разумного порога. А низкий порог ломал синхронизацию файлов с рабочего компьютера, которая льёт запросы пачками. Поэтому медленные атаки ловит fail2ban — с теми граблями, о которых была первая часть цикла.
Поисковик нашёл тестовую копию
Самая неприятная находка в журнале — не атака. Googlebot обошёл 17 адресов тестовой копии рабочего сайта и получил на всё 200. Копия боевого сайта на другом домене — дубль, который поисковик может посчитать оригиналом.
Закрыл заголовком на точке входа прокси — так он ставится на все сайты сервера сразу, включая те, что появятся завтра:
# traefik.yml — статическая конфигурация
entryPoints:
  https:
    address: ":443"
    http:
      middlewares: [noindex@file]

# providers/noindex.yml
http:
  middlewares:
    noindex:
      headers:
        customResponseHeaders:
X-Robots-Tag: "noindex, nofollow, noarchive, nosnippet"- почему заголовок, а не robots.txt: robots.txt запрещает обход, но не индексацию — адрес, найденный по внешней ссылке, может попасть в выдачу и без обхода. К тому же robots.txt лежит в файлах проекта и уедет на боевой сайт;
- грабля:
traefik.ymlсмонтирован в контейнер файлом, иdocker compose up -dпосле правки контейнер не пересоздаёт. Нуженdocker restart.
ИИ-краулеры: noindex им не указ
Когда я включил запись User-Agent в журнал (по умолчанию traefik отбрасывает заголовки запроса, и вместо агента в журнале был прочерк), картина дополнилась. За два часа на два сайта пришло 1202 и 1101 запрос. GPTBot за пять минут сделал 446 запросов — около 90 в минуту — по папке загрузок и кэшу миниатюр. Рядом ClaudeBot и пачка SEO-сканеров. Запрет индексации их не останавливает: они слушают только robots.txt, а его на тестовых копиях менять нельзя.
Отдельный роутер по заголовку User-Agent, приоритет выше всех остальных:
block-ai-crawlers:
  rule: "HeaderRegexp(`User-Agent`, `(?i)(GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|anthropic-ai|CCBot|Bytespider|Amazonbot|meta-externalagent|PerplexityBot|AhrefsBot|SemrushBot|MJ12bot|DotBot|PetalBot)`)"
  priority: 101000
  middlewares: [deny-all]
  service: noop
Проверка по секундам: правило применено в 12:30:53, последний ответ 200 краулеру — в 12:30:55, дальше только 403.
Не блокируйте пустой User-Agent: с ним ходят ваши же проверки через curl и Let’s Encrypt при выпуске сертификатов.
Это решение для тестового сервера. Для боевого сайта, который хочет попадать в ответы ИИ-ассистентов, такие боты, наоборот, полезны — там их пускают и управляют ими через robots.txt.
Что ещё нашлось
- сканер, охотящийся за секретами разработчиков:
/.vscode/settings.json,/.netrc, конфиги ИИ-ассистентов в редакторах. Ходит через облачную платформу CDN, по адресу его от обычного посетителя не отличить; /wp-config.phpотвечал 200 с пустым телом. Исходник не утекал — PHP его исполнял и ничего не выводил, — но сам ответ 200 сообщает сканеру «здесь WordPress». Закрыт;- налёт: 2602 запроса за три минуты, поиск
.envво всех папках. На корне голого адреса лежит статическая страница на 118 байт, и/?file=../../.envполучал 200 с ней — сканер решил, что нашёл конфиг; - журнал этой страницы показывал у всех запросов адрес прокси вместо адреса клиента. Лечится в nginx:
set_real_ip_from 172.16.0.0/12; real_ip_header X-Forwarded-For; real_ip_recursive on;.
Не знаете, кто ходит на ваш сервер?
Пришлите журнал обращений за сутки — разберу, что в нём атака, что роботы, а что люди, и что из этого стоит закрыть.



// загружаю комментарии…