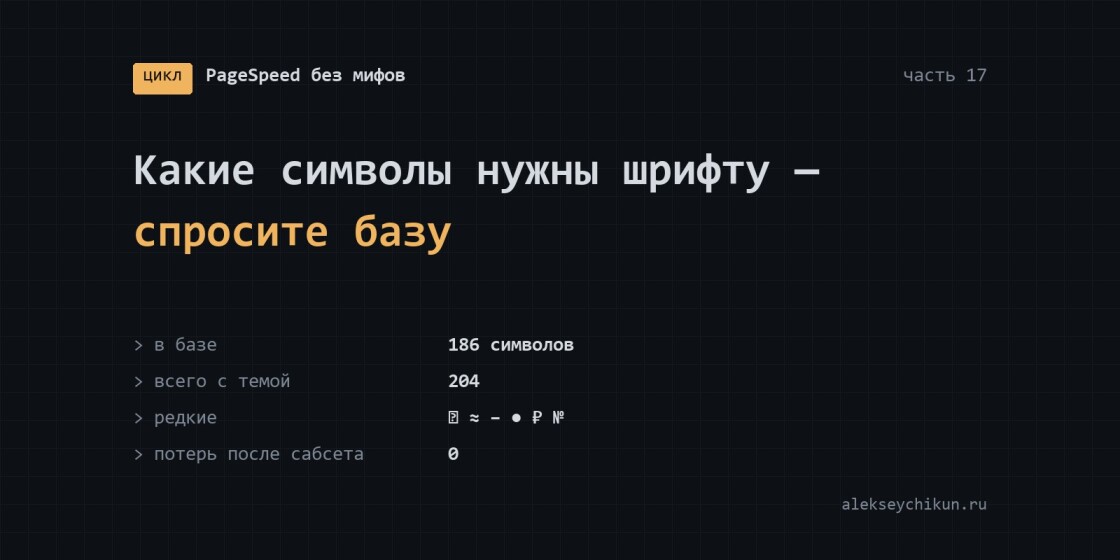
Когда режут шрифт под сайт, набор символов обычно собирают «на глаз» или с нескольких страниц: алфавит, цифры, знаки препинания, кавычки. А потом в карточке товара где-то в глубине каталога всплывает знак диаметра ⌀ или ≈, и браузер рисует его запасным шрифтом — «чужим» символом другой толщины.
Это семнадцатая часть цикла «PageSpeed без мифов» — продолжение шестнадцатой про сабсет шрифтов.
Откуда брать набор символов
Не со страниц, а из базы: там весь контент сайта, включая то, что редко открывают. Для WordPress это заголовки, отрывки и тексты записей, названия рубрик и значения полей. Плюс исходники темы — тексты, которые зашиты в шаблоны.
<?php
// charset.php — все символы, которые встречаются в контенте сайта WordPress.
// Запуск: php charset.php > chars.txt (из корня сайта)
define('DISABLE_WP_CRON', true);
require __DIR__ . '/wp-load.php';
global $wpdb;

$codes = [];
$add = function (?string $text) use (&$codes) {
	foreach (preg_split('//u', html_entity_decode(wp_strip_all_tags((string) $text)), -1, PREG_SPLIT_NO_EMPTY) as $ch) {
		$codes[mb_ord($ch)] = true;
	}
};
foreach ($wpdb->get_results("SELECT post_title, post_excerpt, post_content FROM {$wpdb->posts} WHERE post_status = 'publish'") as $r) {
	$add($r->post_title); $add($r->post_excerpt); $add($r->post_content);
}
foreach ($wpdb->get_col("SELECT name FROM {$wpdb->terms}") as $t) $add($t);
foreach ($wpdb->get_col("SELECT meta_value FROM {$wpdb->postmeta} WHERE meta_value NOT LIKE 'a:%' AND LENGTH(meta_value) < 5000") as $m) $add($m);

ksort($codes);
echo implode(',', array_map(fn($c) => sprintf('U+%04X', $c), array_keys($codes))), "\n";
На каталоге сельхозтехники скрипт нашёл в базе 186 разных символов, ещё 184 — в исходниках темы. В объединении — 204: большая часть, конечно, совпадает.
Что находится таким способом
Редкие, но живые символы, которых нет в «стандартных» наборах:
| Символ | Где встретился |
|---|---|
| ⌀ (U+2300) | размеры шин в характеристиках |
| ≈ (U+2248) | примерные значения в описаниях |
| − (U+2212) | настоящий минус в температурах и допусках |
| ● (U+25CF) | маркеры в списках из редактора |
| ₽ (U+20BD) | цены |
| № (U+2116) | номера документов и моделей |
Проверка: ни одной потери
Мало собрать набор — нужно убедиться, что всё нужное осталось в урезанном файле. Сравниваем три множества: нужные символы, символы исходного шрифта и символы сабсета.
# сколько нужных символов потеряно при сабсете: должно быть 0
from fontTools.ttLib import TTFont
need = {int(c[2:], 16) for c in open("chars.txt").read().strip().split(",")}
src = set(TTFont("_source/Montserrat-Regular.ttf").getBestCmap())
sub = set(TTFont("Montserrat-Regular.woff2").getBestCmap())
lost = (need & src) - sub          # было в исходнике, пропало в сабсете
absent = need - src                # нет даже в исходнике шрифта
print("потеряно:", [chr(c) for c in sorted(lost)])
print("нет в исходнике:", [chr(c) for c in sorted(absent)])
«Потеряно» должно быть пустым. А «нет в исходнике» — отдельная находка, и она может удивить.
Сюрпризы из исходников
- В полужирном начертании Open Sans нет знака рубля. Если цена печатается этим весом, ₽ рисовался запасным шрифтом ещё до всякого сабсета — и этого никто не замечал.
- Неразрывного дефиса (U+2011) не оказалось в файле одного из шрифтов, а исходника, чтобы его вернуть, в проекте уже не было. Символ встречается в контенте и рисуется запасным шрифтом.
Что делать с такими символами: заменить в контенте (неразрывный дефис — на обычный), взять другое начертание или шрифт, где символ есть, — или осознанно оставить запасной шрифт для редкого знака. Главное — знать.
Нужно урезать шрифты без риска потерять символы?
Пришлите адрес — соберу набор символов из вашего контента и сделаю сабсет с проверкой.


// загружаю комментарии…